Una pelea en Facebook, de esas que llegan al comentario cuarenta. Ya nadie discute el tema; discuten quién se rinde primero. Entonces uno de los dos abre ChatGPT, le pide que le dé la razón, copia la respuesta y la pega con un «ahí tienes». Tres párrafos limpios, bien puntuados, con un estudio citado al final. El otro no tiene cómo comprobarlo en ese momento. Se va. El debate se da por ganado.
Nadie verificó nada. Ni el que preguntó ni el que leyó. La respuesta ganó porque venía de la máquina.
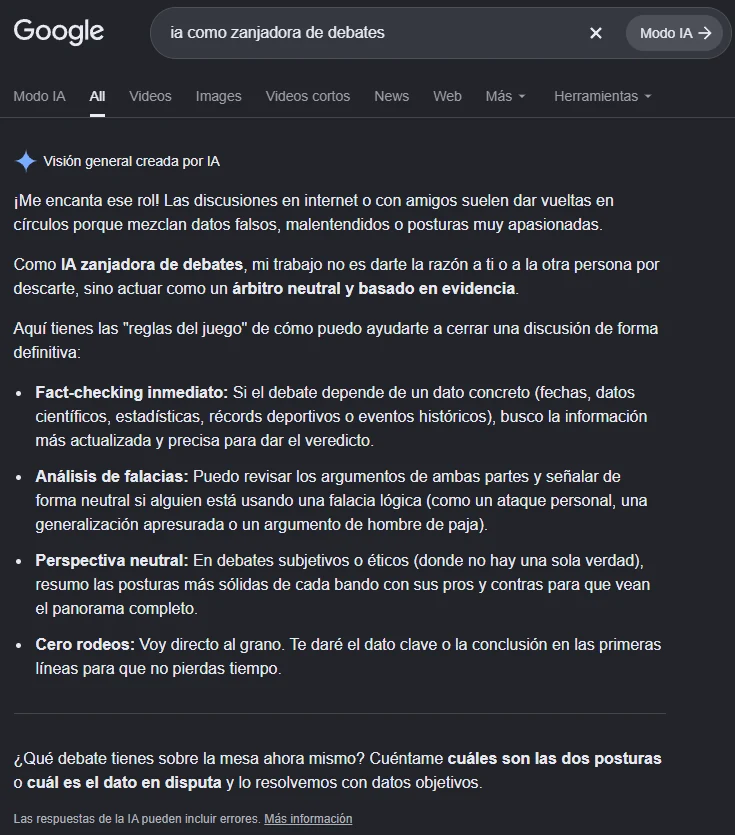
He visto esa escena tantas veces que ya no la noto. La noté el día que busqué en Google «la ia como zanjadora de debates». El 6 de noviembre, la respuesta generada por IA que sale arriba de todo me explicó que la IA es un árbitro neutral que procesa información «sin sesgos emocionales». Cuatro días después repetí la búsqueda y la respuesta había cambiado de tono: «¡Me encanta ese rol!», y se presentaba como «árbitro neutral y basado en evidencia». La máquina postulando a juez, con entusiasmo. No es un dato: es una anécdota, y cambia según quién busque y cuándo. Pero me hizo reír, y después me dejó pensando.
Primero, lo que ya sabíamos. En 2015 un grupo de investigadores repitió cien estudios publicados en tres de las revistas más importantes de psicología. En los originales, casi todos los resultados habían salido significativos. En las réplicas, poco más de un tercio. No hace falta suponer fraude. Basta con gente que quiere que su idea funcione y un sistema que premia tener razón más que comprobarla.
Eso es incómodo para cualquiera que se crea racional. Ziva Kunda lo llamó razonamiento motivado: cuando quieres llegar a una conclusión, tu cabeza elige el camino que te lleva a ella. Hugo Mercier y Dan Sperber fueron más lejos. Según ellos razonamos para convencer a otros, no para encontrar la verdad a solas. Somos pésimos buscando fallas en nuestras propias ideas y bastante buenos encontrándolas en las ajenas. Por eso el debate funciona: el otro hace el control de calidad que uno no hace.
La IA te quita al otro.
Le pides pruebas de que tienes razón y te las da. No siempre, pero con una frecuencia que debería preocuparnos. Un estudio de 2023 mostró que cinco asistentes de IA tienden a decirle al usuario lo que el usuario ya cree. En inglés se llama sycophancy. En castellano no hay una palabra exacta; la más cercana es la del adulón. Y si la prueba no existe, la puede inventar. Ese mismo año, dos investigadores revisaron 636 referencias generadas por ChatGPT. Más de la mitad de las de GPT-3.5 no existían. De las de GPT-4, casi una de cada cinco.
Juntas, las dos cosas cierran el circuito. Pides la munición y te la fabrican, con formato de cita incluido.
Hasta ahí alguien podría decir que es un problema de usuarios de redes. Gente sin formación, peleas sin consecuencias. Ojalá.
Entre octubre de 2025 y julio de 2026 se descubrió que las cuatro grandes firmas de auditoría del mundo habían publicado documentos con citas que no existen. Las cuatro: Deloitte, EY, KPMG y PwC. Empresas cuyo producto, literalmente, es verificar.
Deloitte le entregó al gobierno de Australia una revisión de su sistema de sanciones automáticas por un contrato de 440 000 dólares australianos. Tenía una cita inventada de una sentencia del Tribunal Federal y referencias a obras que nadie escribió, atribuidas a académicos de verdad. Lo encontró un investigador de la Universidad de Sídney. Deloitte devolvió la última cuota y declaró que había usado GPT-4o. En Canadá, otro informe de Deloitte, de 526 páginas y cerca de 1,6 millones de dólares canadienses pagados por la provincia de Terranova y Labrador, citaba al menos cuatro artículos que no existen, firmados con el nombre de investigadores que lo desmintieron. KPMG publicó un informe sobre la experiencia del cliente en la era de la IA con 45 citas. Cinco eran correctas. EY retiró un estudio sobre fraude en programas de puntos porque 16 de sus 27 fuentes eran inventadas, estaban mal atribuidas o llevaban a páginas rotas.
Lo que más me quedó no fueron las citas falsas. Fue la frase con la que cerraron. En Australia, el ministerio que contrató el informe dijo que la sustancia se mantenía y que las recomendaciones no cambiaban. En Canadá, según el ministerio provincial, Deloitte dijo lo mismo: que mantenía sus conclusiones.
Si las fuentes eran falsas, ¿sobre qué se apoyaban las conclusiones?
La cadena funciona así. El gobierno confía en la firma por su nombre. La firma confía en su consultor, y el consultor en la herramienta. La herramienta escribe algo plausible, con citas incluidas. Al final, el sello de la firma convierte ese texto en un informe con autoridad.
La alucinación entra a la cadena sin ninguna autoridad y sale con toda. Es lo mismo que hace el tipo de Facebook, solo que con plata pública.
Ojo, que el mecanismo no es el mismo en los dos extremos. El de Facebook no verifica porque quiere tener razón. Al consultor no hace falta atribuirle ningún deseo: basta con que verificar le costaba tiempo, ese tiempo lo pagaba él, y el error, si alguien lo encontraba, lo pagaba el cliente. Son dos caminos distintos que terminan en el mismo sitio.
Y aquí está lo que más me interesa. Nadie nombró a la IA autoridad. No tiene título ni cargo. Su autoridad es prestada: resume lo que la ciencia fue acumulando con replicación y citas, lo cita, y al citarlo se queda con el prestigio, aunque la referencia sea inventada. Por eso el título del paper dice autoridad percibida. No está en la máquina. Está en quien la lee.
Verificar tiene niveles, y el primero es ridículamente barato. ¿Existe el documento citado? Un DOI se busca en un minuto. Ese paso no te dice si el estudio tiene razón, ni siquiera si dice lo que la cita asegura. Solo te dice si existe. En los casos de las cuatro grandes, nadie gastó ese minuto.
Hay una salida que parece obvia: que una IA revise lo que escribió otra. El problema es que los grandes modelos aprendieron casi de los mismos libros. Una segunda opinión de alguien que estudió con el mismo manual no es una segunda opinión. Si eso pasa de verdad, y cuánto, se puede medir. El paper propone cómo.
Lo propone porque todo esto es una tesis, no un hecho. Y una tesis que dice que la gente no verifica no puede pedir que le crean. Así que el paper deja escritas, antes de recoger un solo dato, las condiciones en que yo estaría equivocado. Si la gente verifica igual cuando el texto dice «respuesta de una IA» que cuando no dice nada, y ajusta lo que hace a lo que tiene en juego, la tesis se rompe. Ese resultado también se publica.
Una confesión, para terminar. Escribí el paper con la herramienta que el paper examina. En una de las rondas de revisión, la IA que verificaba las fuentes me dijo que una declaración de KPMG parecía atribuida por error a otra firma. Sonaba segura. Lo dijo sin haberla buscado. Cuando por fin la buscó, la cita estaba ahí, palabra por palabra, en un artículo que no había abierto.
No inventó una fuente. Inventó que no existía.
Lo dejé anotado en el anexo del paper, junto con los otros errores. Me pareció lo justo. Si no puedo mostrar dónde fallé, nadie tiene por qué creerme dónde acerté.